Fondamenti dell'AI
Retrieval-Augmented Generation: Guida Pratica
Davide FiliaggiAggiornato 6 min
La Retrieval-Augmented Generation fa recuperare documenti al modello prima di rispondere. Se l'AI recupera la tua pagina, può citarti nelle sue risposte.
La Retrieval-Augmented Generation è il motivo per cui un assistente AI può citare una pagina pubblicata ieri anche se il suo addestramento si è chiuso mesi fa. Invece di rispondere solo a memoria, il modello prima recupera i documenti rilevanti e li legge. Quel passaggio di recupero ha una conseguenza commerciale diretta: se l'AI recupera la tua pagina, può citarti. Se non la recupera, in quella risposta non esisti, qualunque sia il valore del tuo brand.
La Retrieval-Augmented Generation (RAG) è una tecnica che recupera documenti rilevanti da una fonte di conoscenza esterna e li inserisce nel contesto di un modello linguistico prima che generi la risposta.
L'approccio è nato nel 2020 ed è passato da prototipo di ricerca a pratica standard nell'AI aziendale. Corregge tre debolezze strutturali di un LLM da solo:
- Accuratezza. Ancorare l'output a prove recuperate riduce le allucinazioni.
- Freschezza. Il modello può usare dati pubblicati dopo il suo cutoff di addestramento.
- Verificabilità. Le fonti recuperate sono tracciabili, quindi le risposte si possono controllare.
Come funziona un sistema RAG?
- La domanda dell'utente viene convertita in una rappresentazione ricercabile, in genere un embedding.
- Un retriever interroga una fonte di conoscenza (un vector database, un archivio documentale o il web) e restituisce i passaggi più rilevanti.
- Quei passaggi vengono inseriti nella finestra di contesto del modello insieme alla domanda originale.
- Il modello genera una risposta ancorata al materiale recuperato, spesso citando le fonti usate.
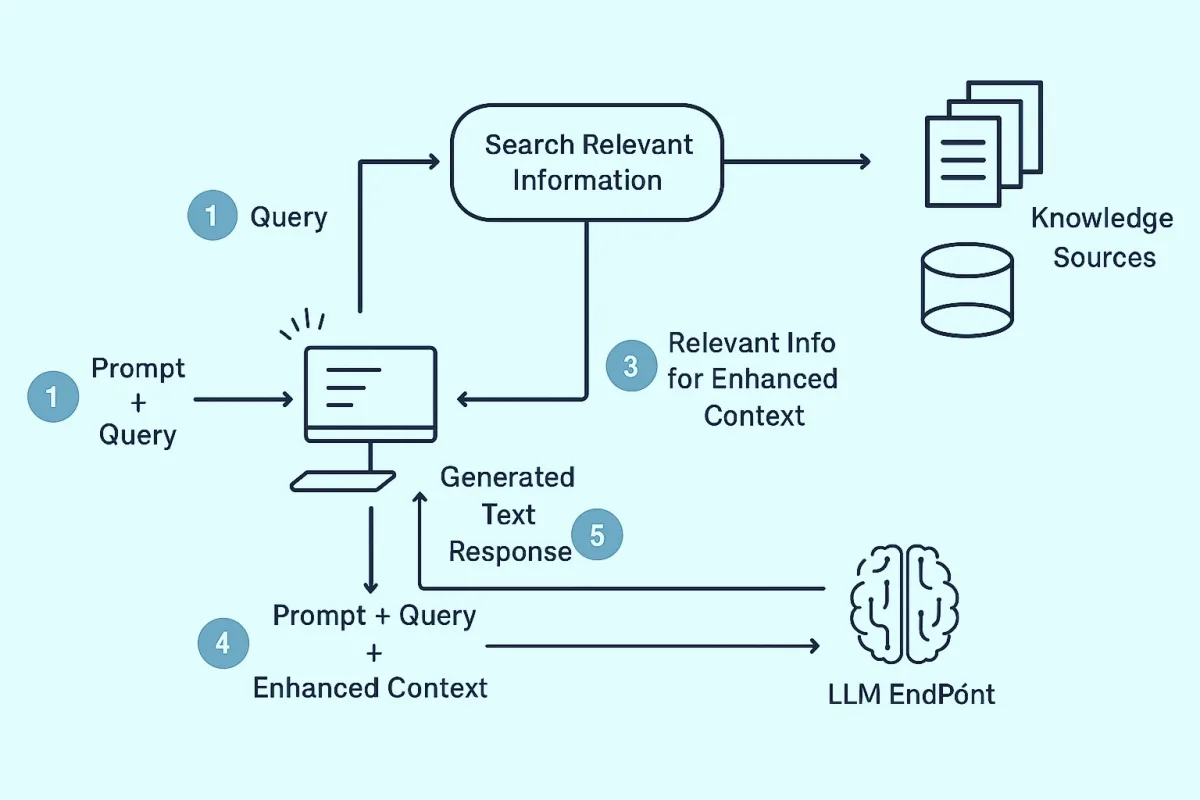
Diagramma che mostra il flusso di lavoro della Retrieval-Augmented Generation (RAG), dall'interrogazione delle fonti di conoscenza al contesto arricchito che alimenta un LLM per la generazione del testo
I ricercatori presenti a EMNLP 2024 descrivono il RAG come uno spazio di progettazione più che come un metodo unico: ogni fase, dal chunking alla strategia di retrieval al reranking, si può regolare sul compito. Il loro paper, Searching for Best Practices in Retrieval-Augmented Generation, mappa le combinazioni che funzionano meglio.
Due scelte di progettazione pesano più delle altre. Il chunking decide come i documenti vengono spezzati in passaggi recuperabili: pezzi troppo lunghi diluiscono la pertinenza, pezzi troppo corti perdono il contesto. Il retriever può essere denso, basato sulla similarità degli embedding, o sparso, basato sulle parole chiave; molti sistemi in produzione combinano i due e aggiungono un passaggio di reranking che riordina i candidati prima che arrivino al modello.
Cosa c'è di nuovo nella ricerca sul RAG?
Dal 2024 la ricerca si è ramificata in più direzioni:
- **GraphRAG**, di Microsoft Research, aggiunge i knowledge graph alla pipeline di retrieval, così il modello può seguire le relazioni tra entità. Utile in compliance, antifrode e ricerca scientifica.
- **MiniRAG** adatta il retrieval ai modelli linguistici piccoli, rendendo il RAG praticabile su dispositivi edge e in contesti con poche risorse.
- **VideoRAG** estende il retrieval ai video, combinando embedding visivi e metadati testuali per trovare i segmenti rilevanti.
- SafeRAG misura la sicurezza, mettendo alla prova le pipeline contro fughe di dati, prompt injection e manipolazioni avversarie.
- **Agentic RAG** porta il retrieval dentro flussi di lavoro agentici a più passaggi, dove un modello pianifica, recupera e agisce in sequenza.
Come si porta il RAG in produzione?
Quattro framework open source coprono la maggior parte del lavoro di implementazione:
- **LangChain**, la suite più ampia, con LangSmith per il debugging.
- **LlamaIndex**, specializzato nel collegare gli LLM a dati privati e strutturati, con oltre 300 integrazioni.
- **Haystack**, pipeline modulari con un builder visuale pensato per i team enterprise.
- **LightRAG**, un'implementazione leggera costruita per la velocità.
Per iniziare in pratica, Hugging Face pubblica un tutorial RAG from scratch. Sul fronte storage, le scelte comuni includono Pinecone, Weaviate, Milvus e pgvector, che differiscono soprattutto per scala, modello di hosting e costi.
Gli osservatori del settore convergono su due punti. Squirro sostiene che il RAG è diventato la spina dorsale della gestione della conoscenza aziendale. TechRadar aggiunge che il retrieval rende al massimo quando è abbinato a una gestione documentale solida e alla ricerca per metadati. Input trascurati producono retrieval trascurato, qualunque sia il modello.
Anche la valutazione è maturata. RAGEval genera dataset di test specifici per dominio, RAGBench offre 100.000 esempi in cinque settori e BenchmarkQED di Microsoft automatizza gli stress test delle pipeline di retrieval.
Perché il RAG decide la tua visibilità AI?
Ogni motore di risposta consumer è RAG su scala web. ChatGPT con la ricerca, Perplexity, Gemini e le AI Overviews di Google recuperano pagine dal vivo prima di generare, poi citano una parte di ciò che hanno recuperato.
Questo cambia il significato di visibilità. I dati di addestramento di un modello sono congelati; il retrieval no. Se la tua pagina è scansionabile, ben strutturata e risponde in modo diretto a una domanda, può essere recuperata oggi e citata oggi. Se il retrieval ti salta, l'assistente consiglia qualcun altro.
Ne seguono tre mosse pratiche:
- Fai entrare i crawler AI. GPTBot, PerplexityBot e ClaudeBot rispettano robots.txt: bloccarli ti toglie dal retrieval.
- Rendi le pagine citabili. Definizioni dirette e titoli chiari sopravvivono alla selezione dei passaggi, la stessa meccanica che descriviamo in come ChatGPT sceglie le sue fonti.
- Indica ai modelli i tuoi contenuti migliori con un file llms.txt.
La stessa logica gira dentro le risposte che leggono i tuoi potenziali clienti. Chiedi a un assistente quali fornitori considerare nella tua categoria: i nomi che elenca arrivano dalle pagine che il suo retrieval ha recuperato pochi secondi prima. In quel momento non conta il brand; conta quali pagine sono entrate nella finestra di contesto.
Capire come funzionano i modelli sottostanti rende il pattern evidente: un sistema che prevede a partire dal contesto citerà ciò che quel contesto contiene. RankWit monitora quali pagine vengono davvero recuperate e citate dai motori.
FAQ
ChatGPT usa il RAG?
Sì, ogni volta che cerca sul web. ChatGPT con la navigazione o la ricerca recupera pagine in tempo reale, le inserisce nel contesto e risponde con citazioni: è RAG applicato al web aperto. Senza ricerca risponde solo dai parametri appresi durante l'addestramento, quindi le risposte possono essere datate e prive di fonti.
Che differenza c'è tra RAG e fine-tuning?
Il fine-tuning modifica i pesi del modello con addestramento aggiuntivo: incorpora la conoscenza, ma è lento, costa a ogni iterazione e invecchia. Il RAG lascia il modello intatto e fornisce la conoscenza al momento della domanda: aggiornare i dati significa aggiornare i documenti nell'indice di retrieval. Molti sistemi in produzione combinano le due cose.
Cos'è un vector database?
Un vector database archivia embedding, rappresentazioni numeriche del testo, e trova le voci più vicine per significato a una query, invece delle sole corrispondenze di parole chiave. È il livello di retrieval della maggior parte dei sistemi RAG. Pinecone, Weaviate, Milvus e pgvector sono scelte comuni, diverse soprattutto per scala, hosting e costi.
Il RAG può ancora avere allucinazioni?
Sì, ma meno spesso. Ancorare le risposte a documenti recuperati riduce molto le invenzioni, però il modello può fraintendere una fonte, fondere male due passaggi o ripiegare sulla memoria parametrica quando il retrieval non trova nulla di utile. Benchmark come RAGBench e SafeRAG esistono proprio perché anche i sistemi ancorati vanno verificati.
Da leggere dopo
Fondamenti dell'AI7 min
Come funzionano i modelli linguistici di grandi dimensioni
Un LLM prevede il token successivo con reti transformer addestrate su enormi quantità di testo. Tokenizzazione, attention e RLHF spiegano tutto il resto.
 Davide Filiaggi
Fondamenti dell'AI6 min
Come funzionano i motori di ricerca: dalla scansione al ranking
Un motore di ricerca scopre le pagine (crawling), le organizza (indicizzazione) e le ordina (posizionamento). I motori generativi aggiungono la risposta.
Davide Filiaggi
SEO tecnica per l'AI5 min
Cos'è il file llms.txt e perché il tuo sito web ne ha bisogno ora
llms.txt è un file Markdown nella root del sito che elenca le pagine che i modelli AI come ChatGPT dovrebbero leggere per prime, così possono citarti.
Davide Filiaggi